Этот ноутбук — рабочая часть первой лекции. Две физические задачи — случайное блуждание и оценка \(\pi\) методом Монте-Карло — имеют точный ответ, и на них видно, как устроены массивы NumPy, где теряется точность, как измерять время и когда помогает Numba.
на своём компьютере: python -m pip install numpy matplotlib numba jupyterlab, затем jupyter lab и открыть файл;
в браузере: Google Colab, «Файл → Загрузить блокнот»; NumPy, Matplotlib и Numba там уже установлены.
Ячейки выполняются сверху вниз: Shift+Enter выполняет текущую ячейку. Время выполнения, напечатанное ниже, зависит от машины; на вашей оно будет другим.
1 Рабочая среда
import sysimport numpy as npimport matplotlibimport matplotlib.pyplot as pltimport numbaprint("Python ", sys.version.split()[0])print("NumPy ", np.__version__)print("Matplotlib", matplotlib.__version__)print("Numba ", numba.__version__)
Версии печатаются в начале каждого ноутбука: численный результат воспроизводим, только если известно, чем он получен.
2 Цикл Python и массив NumPy
Сумма квадратов миллиона чисел — сначала циклом, потом одной операцией над массивом.
n =1_000_000values = np.arange(n, dtype=np.float64)def sum_squares_loop(a): total =0.0for v in a: total += v * vreturn total%timeit -n 1-r 3 sum_squares_loop(values)%timeit -n 10-r 3 np.sum(values * values)
140 ms ± 174 μs per loop (mean ± std. dev. of 3 runs, 1 loop each)
585 μs ± 116 μs per loop (mean ± std. dev. of 3 runs, 10 loops each)
Цикл Python на каждом шаге проверяет типы и создаёт объекты; NumPy выполняет тот же цикл в скомпилированном коде над непрерывным блоком памяти. Разница — два порядка.
a = np.zeros(6)b = a[::2] # вид на те же данныеb[0] =100.0print("после b[0] = 100: a =", a) # a тоже изменилсяc = a[::2].copy() # независимая копияc[1] =-1.0print("после c[1] = -1: a =", a) # a не изменился
после b[0] = 100: a = [100.   0.   0.   0.   0.   0.]
после c[1] = -1:  a = [100.   0.   0.   0.   0.   0.]
2.3 Broadcasting
Массивы разной формы согласуются по правилу: размерности сравниваются справа, размерность 1 растягивается.
x = np.array([0.0, 1.0, 2.0]) # форма (3,)y = np.array([[0.0], [10.0]]) # форма (2, 1)print(x + y) # форма (2, 3)pts = np.array([[0.0, 0.0], [3.0, 4.0], [6.0, 8.0]])d = np.linalg.norm(pts[:, None, :] - pts[None, :, :], axis=-1)print(d) # все попарные расстояния без цикла
последовательно (cumsum): 1.087937e+06
np.sum (попарно):         1.0000001e+06
float64:                  1000000.0149011612
Последовательная сумма ошибается на 9%: когда сумма велика, прибавка \(0.1\) округляется. np.sum складывает попарно, и ошибка растёт медленнее.
4 Случайные числа
Генератор создаётся один раз с явным seed; с тем же seed результат повторяется.
rng = np.random.default_rng(seed=2026)print(rng.integers(0, 10, size=8))print(np.random.default_rng(seed=2026).integers(0, 10, size=8)) # то же самоеprint(rng.integers(0, 10, size=8)) # продолжение
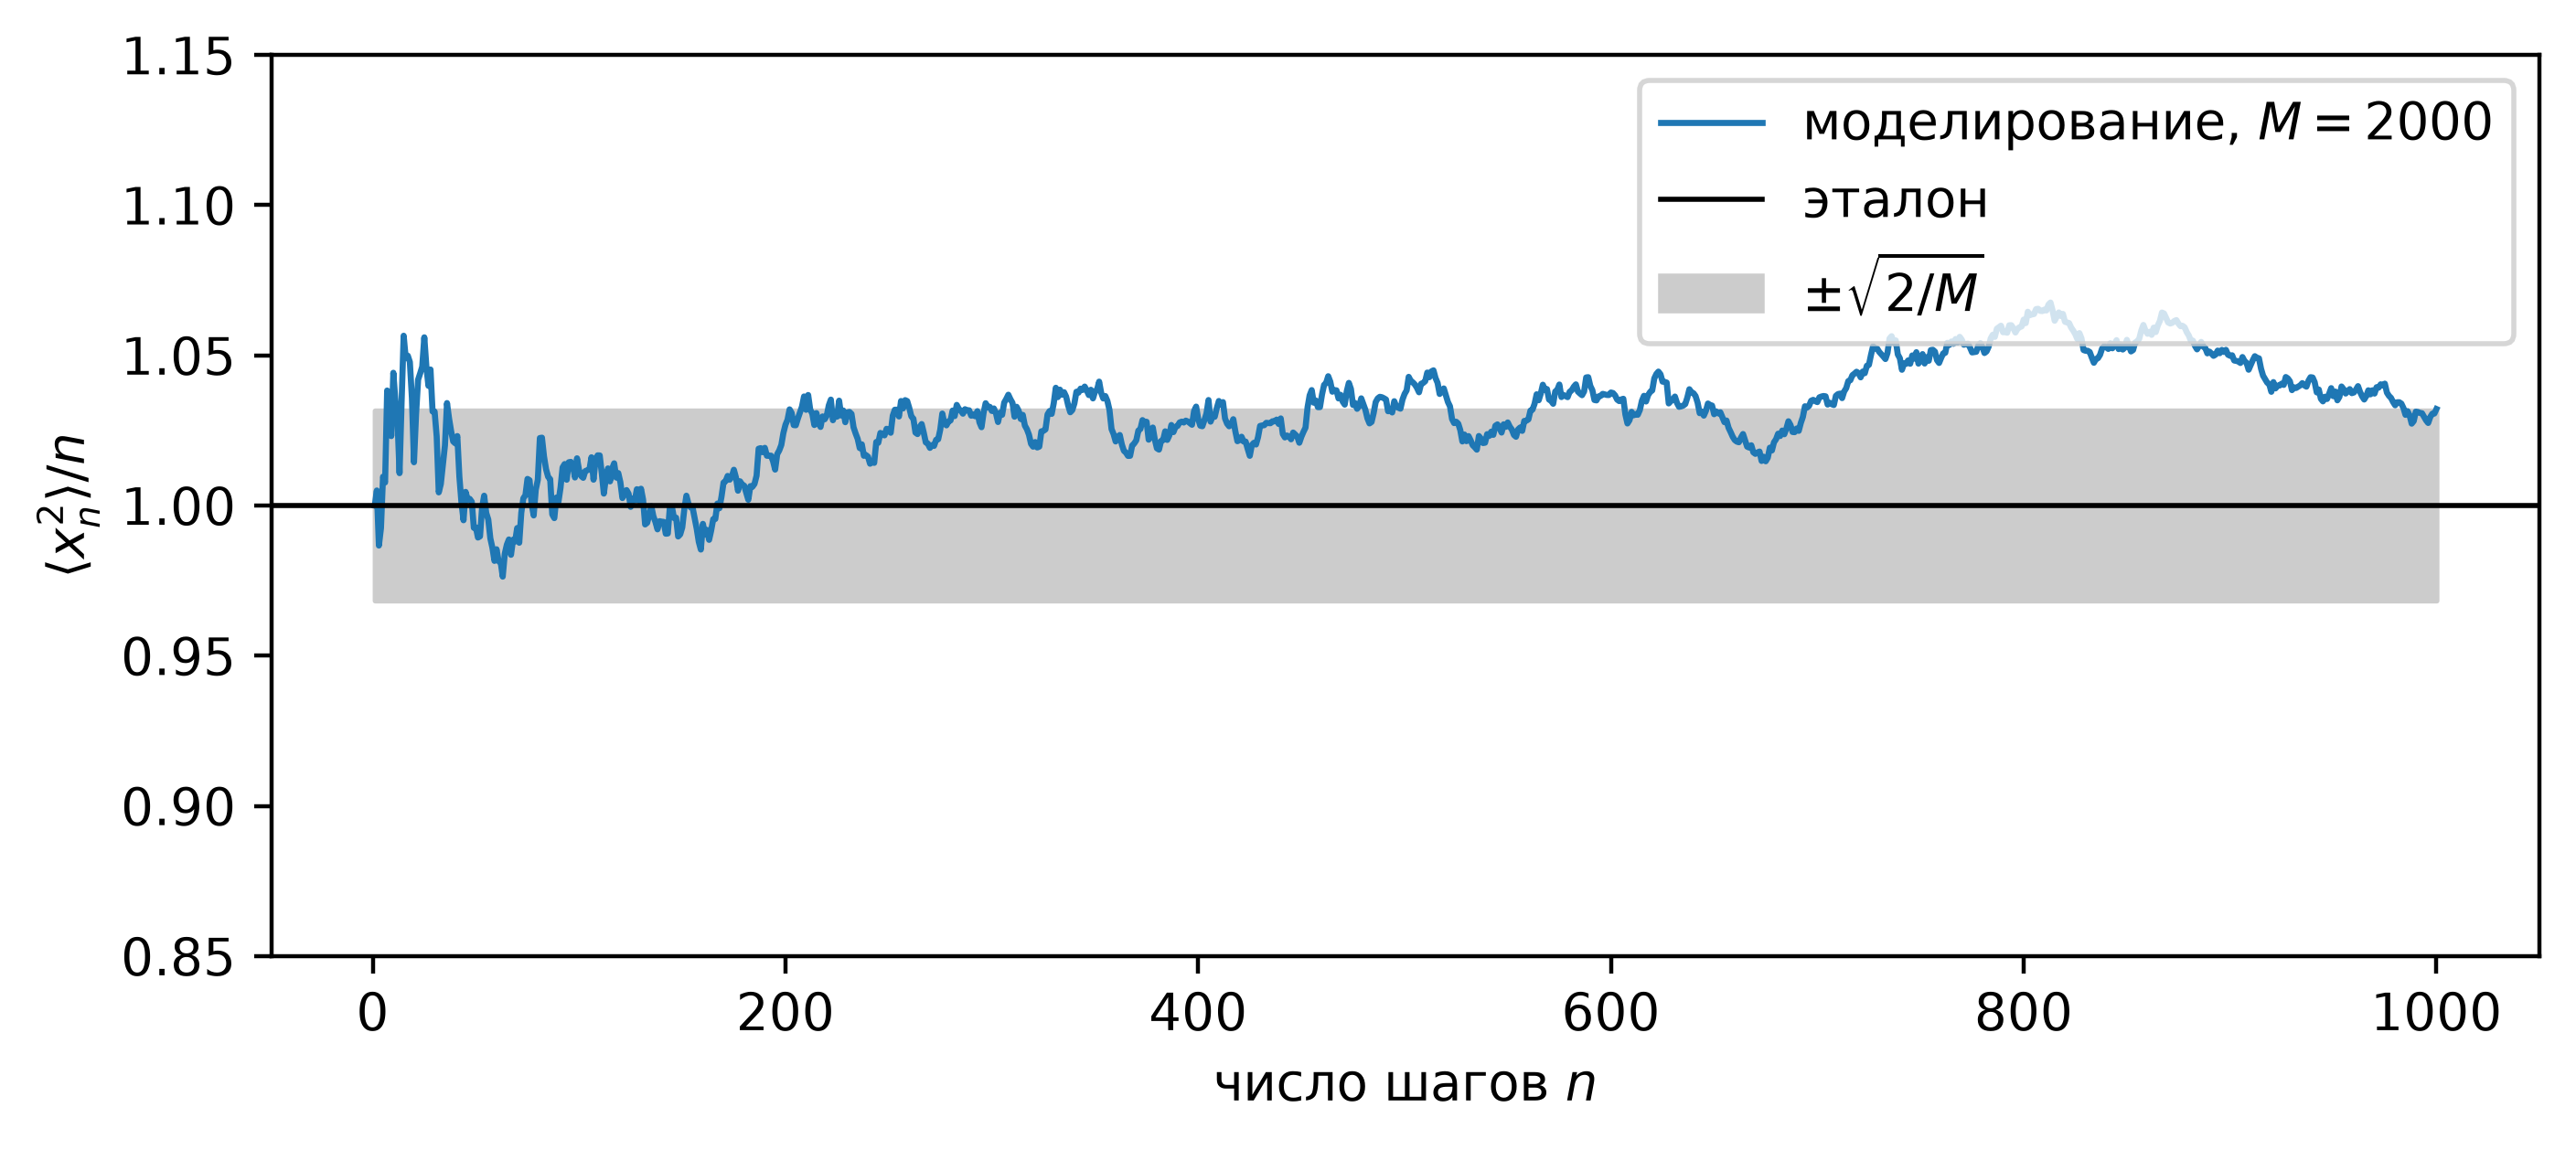
Частица делает \(N\) шагов \(s_i=\pm 1\) с вероятностью \(1/2\). Положение \(x_N=\sum_{i=1}^N s_i\). Шаги независимы, \(\langle s_i\rangle=0\), \(\langle s_i^2\rangle=1\), поэтому \[
\langle x_N\rangle = 0, \qquad \langle x_N^2\rangle = N .
\] Это эталон: проверим, что моделирование его воспроизводит.
Насколько среднее по \(M\) блужданиям может отличаться от \(N\)? Для \(x_N^2\) дисперсия равна \(\langle x_N^4\rangle-N^2=2N^2-2N\), поэтому относительная статистическая ошибка \(\langle x_N^2\rangle/N\) близка к \(\sqrt{2/M}\).
Рисунок 1: Отношение \(\langle x_n^2\rangle/n\) к эталону 1; полоса — статистическая ошибка \(\pm\sqrt{2/M}\).
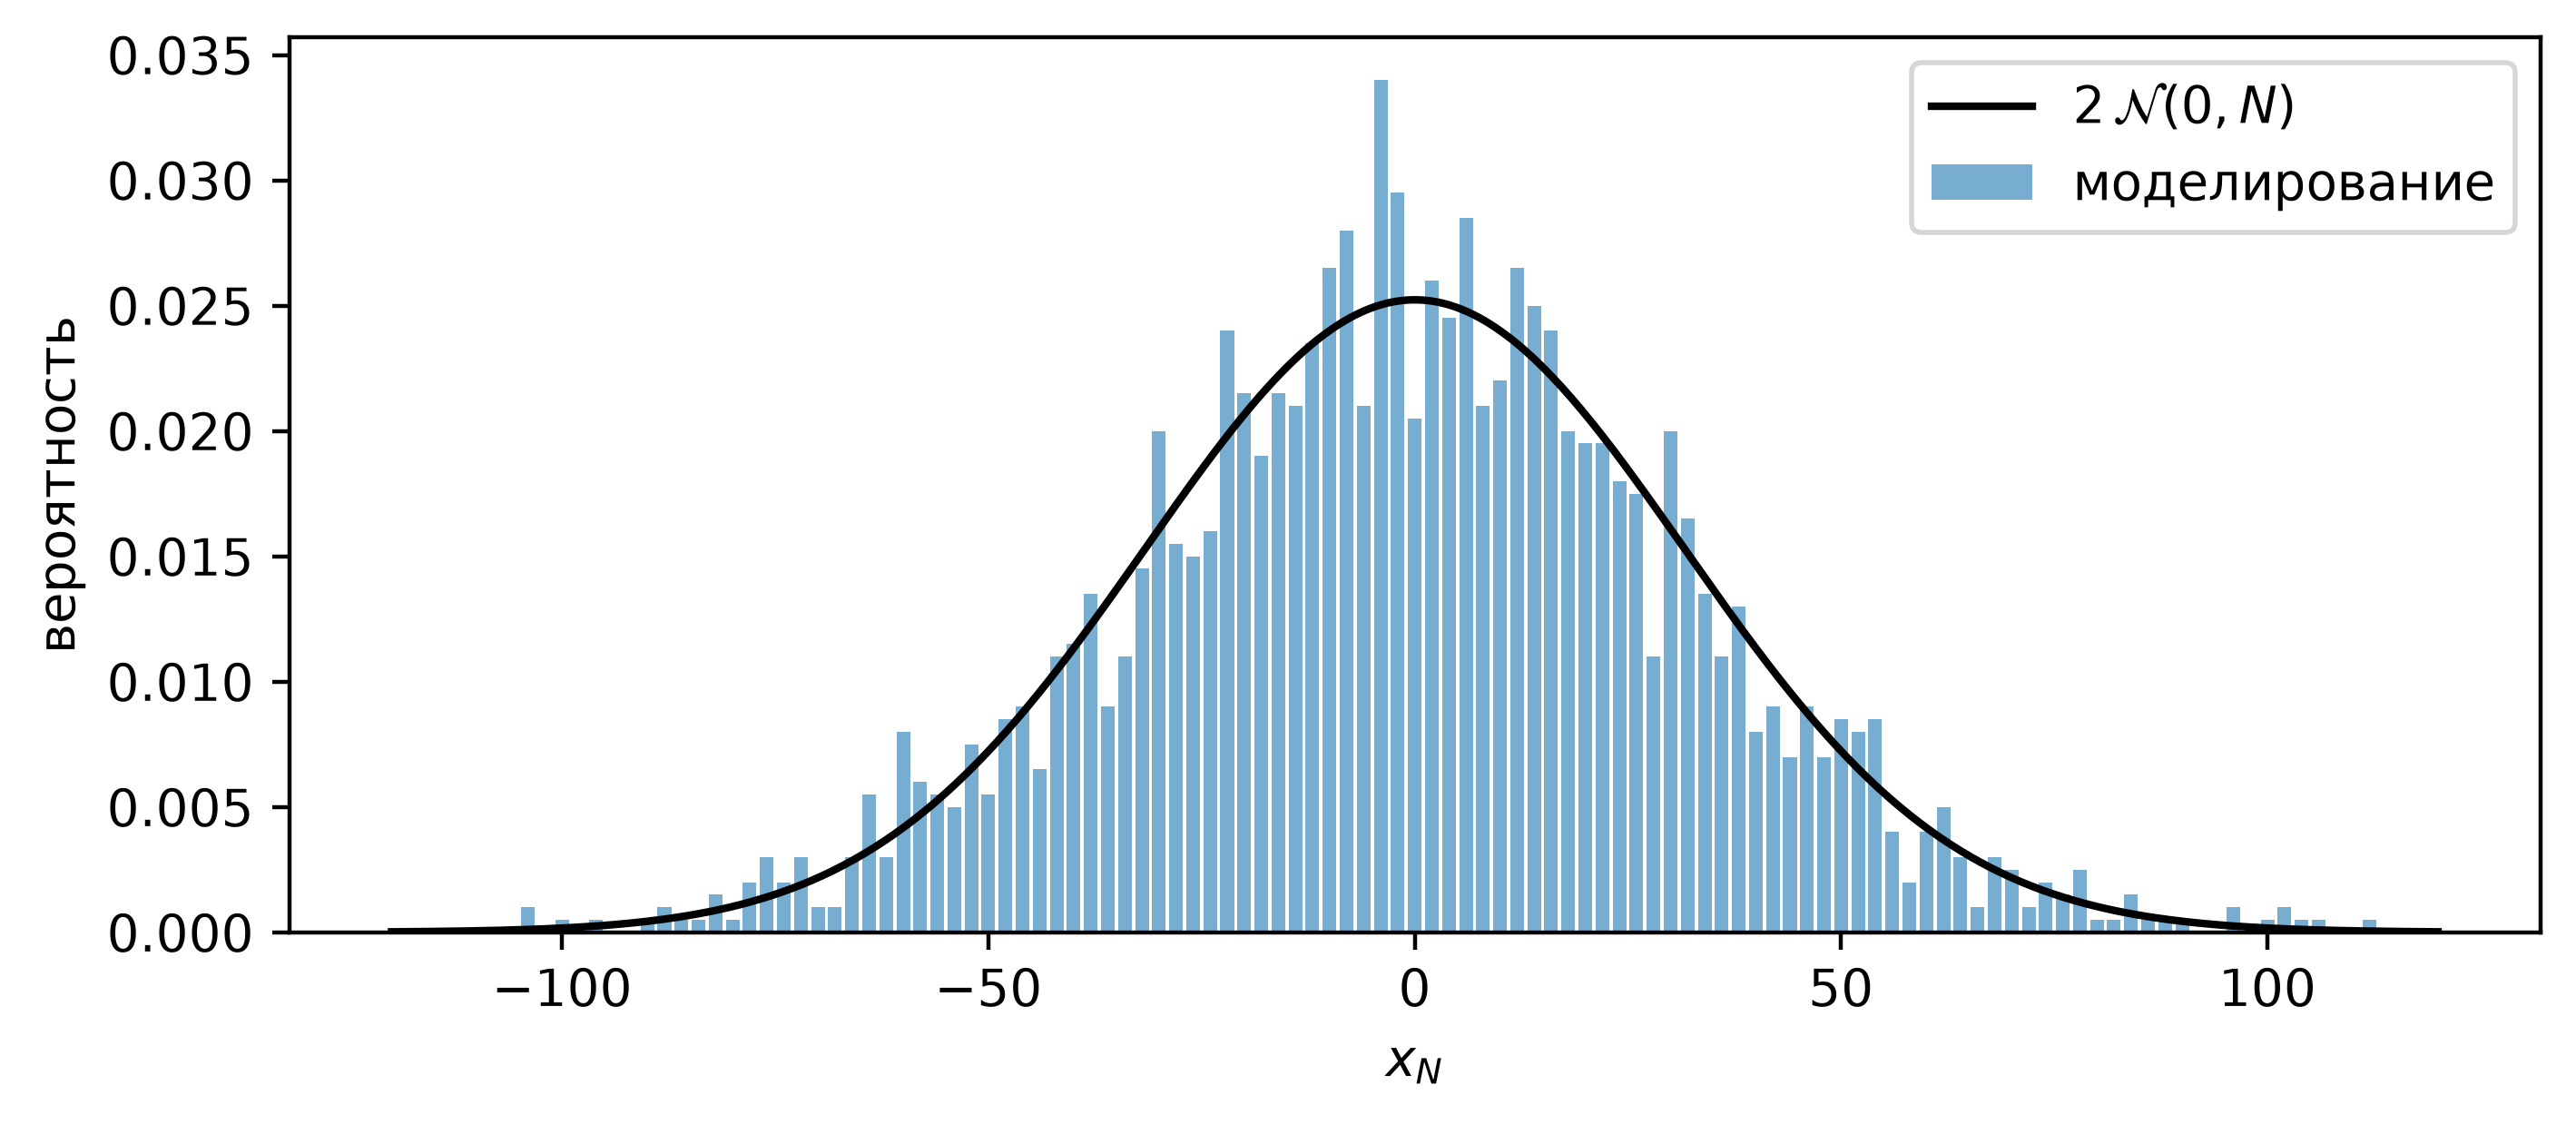
При больших \(N\) распределение \(x_N\) близко к гауссову с дисперсией \(N\). Тонкость: \(x_N\) имеет ту же чётность, что \(N\), поэтому возможные значения идут через 2 и вероятность каждого значения вдвое больше гауссовой плотности.
Рисунок 2: Распределение положения после \(N=1000\) шагов и гауссов предел.
6 Задача 2. Число \(\pi\) методом Монте-Карло
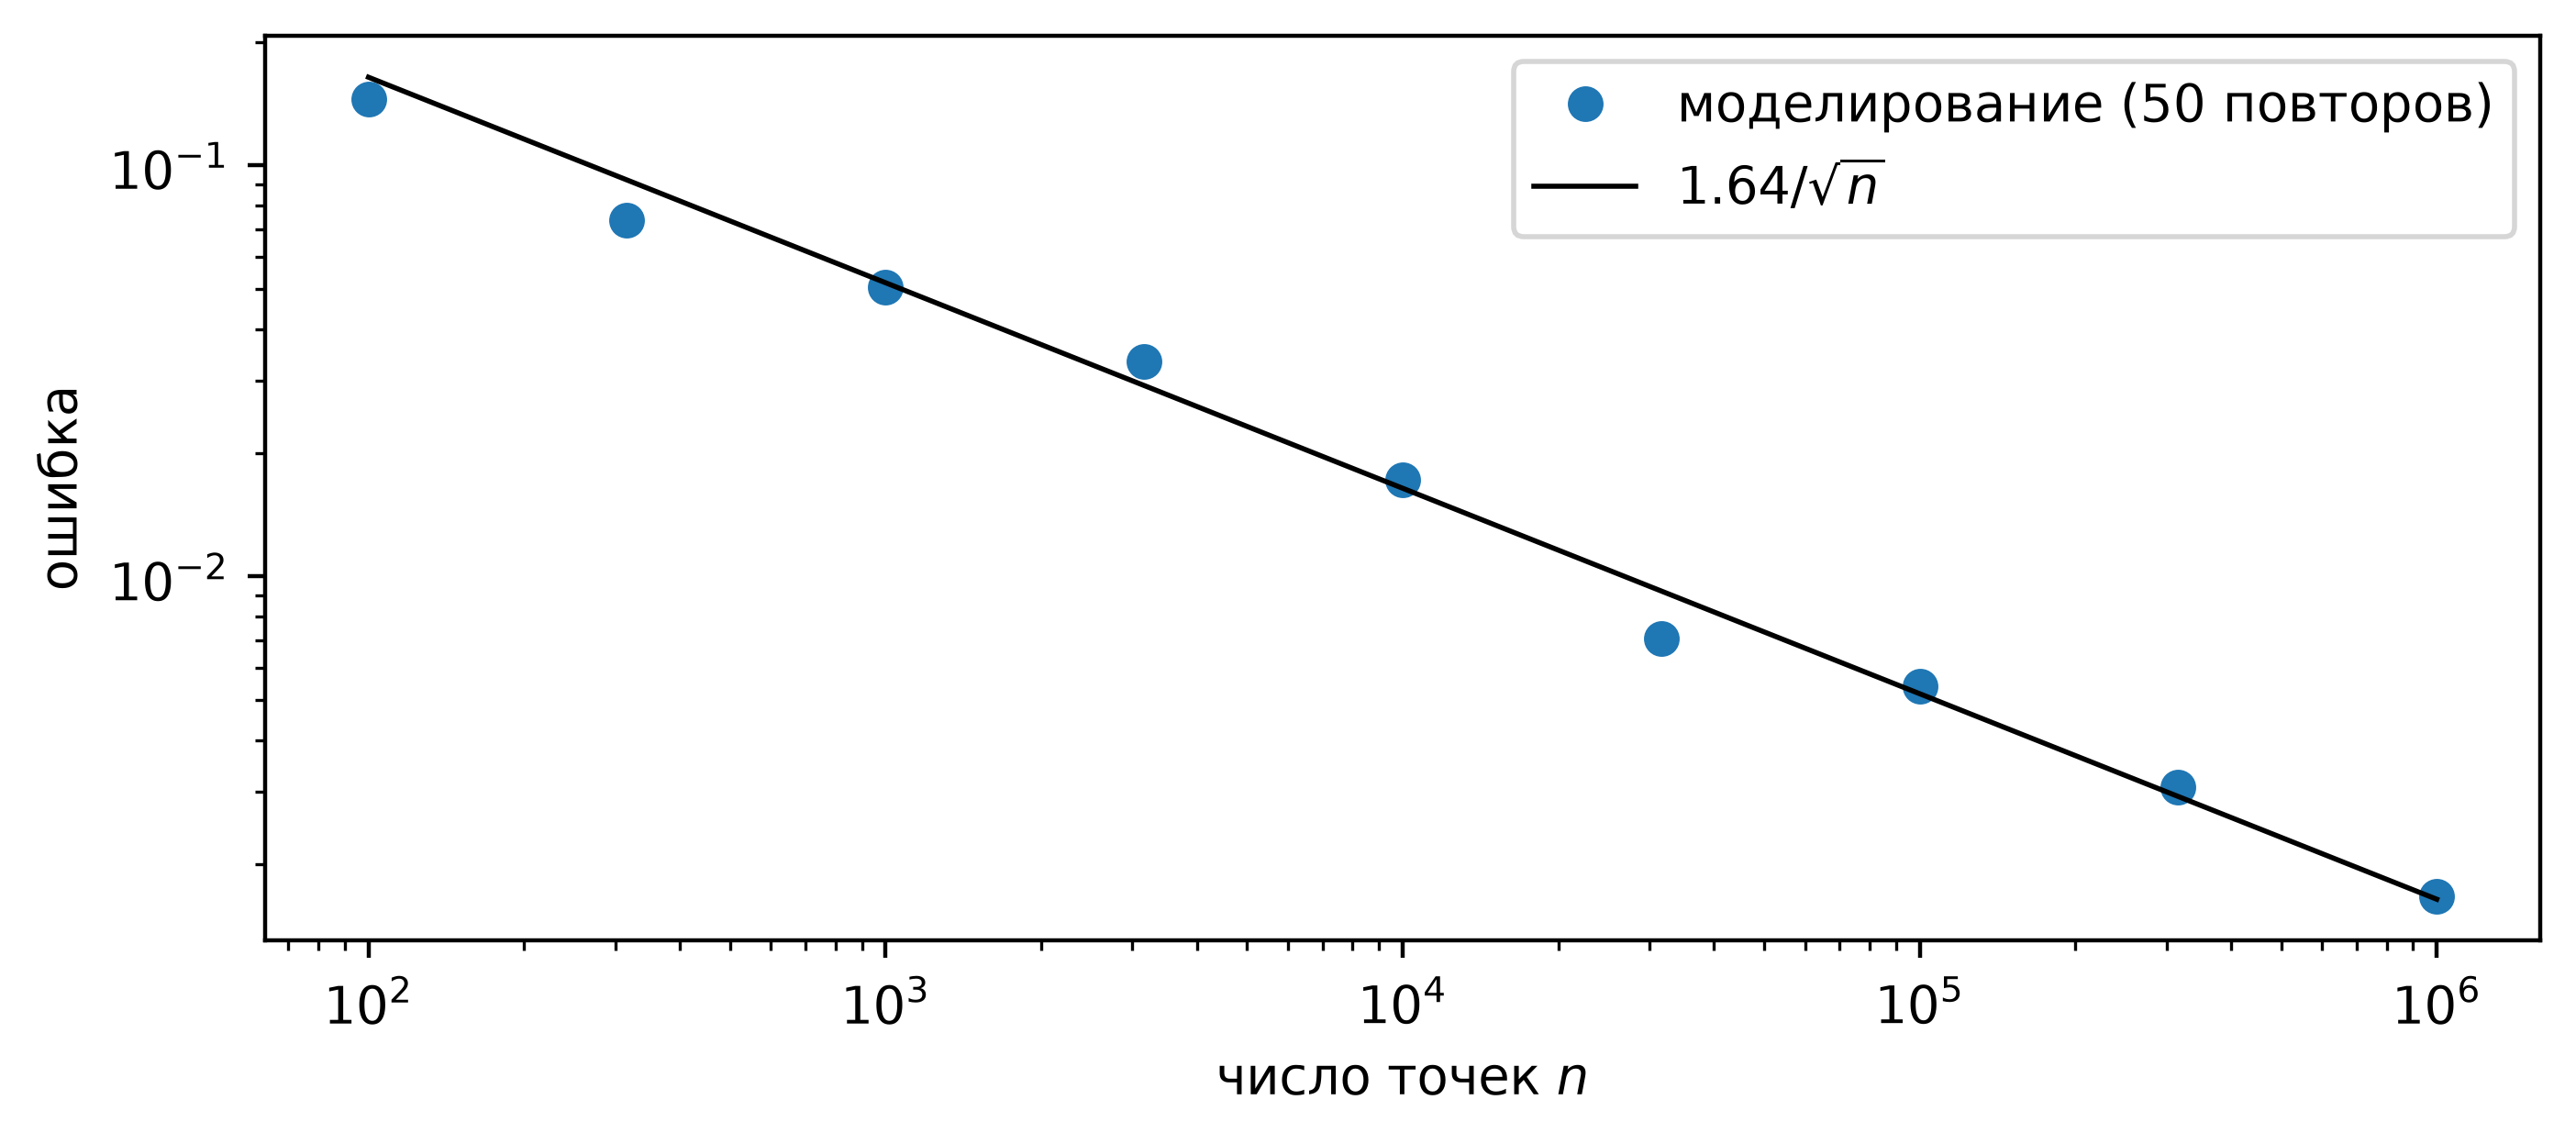
Бросаем \(n\) точек равномерно в квадрат \([0,1]^2\). Доля точек внутри четверти круга стремится к \(p=\pi/4\). Оценка \(\hat\pi=4\,k/n\) имеет стандартное отклонение \[
\sigma_{\hat\pi} = 4\sqrt{\frac{p(1-p)}{n}} \approx \frac{1.64}{\sqrt n}.
\]
def pi_numpy(n, rng): xy = rng.random((n, 2)) inside = (xy **2).sum(axis=1) <1.0return4.0* inside.mean()rng = np.random.default_rng(seed=3)for n in [10**2, 10**4, 10**6]: est = pi_numpy(n, rng)print(f"n = {n:>8}: pi ~ {est:.5f}, ошибка {est - np.pi:+.5f}, "f"ожидаемая {1.64/ np.sqrt(n):.5f}")
n =      100:  pi ~ 3.20000,  ошибка +0.05841,  ожидаемая 0.16400
n =    10000:  pi ~ 3.13760,  ошибка -0.00399,  ожидаемая 0.01640
n =  1000000:  pi ~ 3.14054,  ошибка -0.00105,  ожидаемая 0.00164
Проверим закон \(1/\sqrt n\): для каждого \(n\) повторим оценку 50 раз и найдём среднеквадратичное отклонение от точного \(\pi\).
Рисунок 3: Ошибка оценки \(\pi\) убывает как \(1/\sqrt{n}\).
Чтобы получить ещё один верный знак, точек нужно в 100 раз больше. Для \(n=10^8\) массив координат занял бы 1.6 ГБ: векторизация NumPy упирается в память.
7 Numba: компиляция цикла
Numba компилирует функцию Python в машинный код при первом вызове. Цикл, записанный «как на бумаге», работает со скоростью C и не требует памяти под все точки сразу.
from numba import njit@njitdef pi_numba(n, seed): np.random.seed(seed) # у Numba свой генератор; seed задаётся внутри hits =0for _ inrange(n): x = np.random.random() y = np.random.random()if x * x + y * y <1.0: hits +=1return4.0* hits / n
Первый вызов включает компиляцию, следующие — нет.
import timedef timed(f, *args): t0 = time.perf_counter() result = f(*args)return result, time.perf_counter() - t0_, t_first = timed(pi_numba, 10**6, 5)_, t_second = timed(pi_numba, 10**6, 5)_, t_numpy = timed(pi_numpy, 10**6, np.random.default_rng(5))est, t_big = timed(pi_numba, 10**8, 5)print(f"Numba, первый вызов (с компиляцией), n=1e6: {t_first:8.3f} с")print(f"Numba, второй вызов, n=1e6: {t_second:8.3f} с")print(f"NumPy, n=1e6: {t_numpy:8.3f} с")print(f"Numba, n=1e8: pi ~ {est:.6f}, ошибка {est - np.pi:+.6f}, время {t_big:.2f} с")
Numba, первый вызов (с компиляцией), n=1e6:    0.479 с
Numba, второй вызов,                 n=1e6:    0.020 с
NumPy,                               n=1e6:    0.029 с
Numba, n=1e8: pi ~ 3.141380, ошибка -0.000213, время 1.99 с
Когда Numba не помогает: функция уже состоит из одной-двух операций NumPy (они и так скомпилированы), функция вызывается один раз и компиляция дороже счёта, код использует объекты, которых Numba не знает (словари произвольных типов, pandas, большинство функций SciPy).
8 Итоги
Массив NumPy — блок памяти с формой и типом; операции над массивом выполняются в скомпилированном коде.
Срез — вид на те же данные; копия делается явно.
Точность конечна: \(\varepsilon\approx 2.2\cdot10^{-16}\) для float64, \(1.2\cdot10^{-7}\) для float32; порядок суммирования важен.
Случайные числа — из генератора с явным seed.
Результат проверяется по эталону: \(\langle x_N^2\rangle=N\), ошибка Монте-Карло \(\propto 1/\sqrt n\).
Numba ускоряет циклы, которые не векторизуются или не помещаются в память.